

1. 何が発表されたのか
OpenAIは2026年9月10日、公式ブログで「GPT-Live-1」のAPI提供開始を発表しました。GPT-Live-1は、音声を聞きながら同時に話すことができる、いわゆる「全二重(full-duplex)」の音声モデルです。
この仕組み自体は目新しいものではありません。ChatGPTのアプリでは2026年7月8日に同じ技術がすでに導入されており、今回の発表は、それをAPI経由で自社のサービスに組み込めるようにした、という位置づけです。つまり、ChatGPTのアプリで体験できていた自然な会話のやり取りを、企業が自社の電話窓口や予約システムに組み込めるようになった、ということになります。
料金面では、音声のやり取りを担うフロント部分(音声レイヤー)が1分あたり0.05ドルという形で示されました。この料金の意味については、本記事の後半で詳しく整理します。まずは、GPT-Live-1が従来の音声AIと何が違うのかを見ていきます。
2. 「聞きながら話す」とは何が違うのか
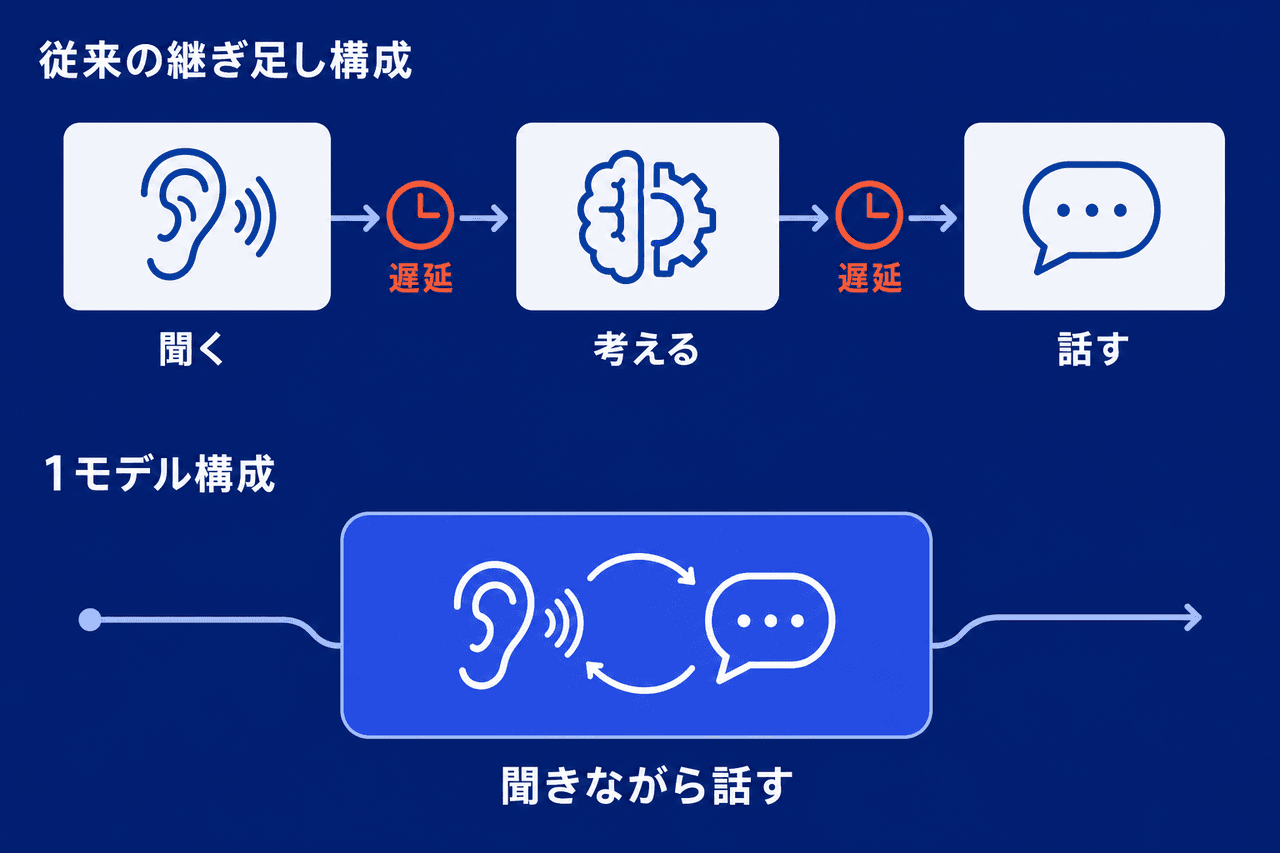
これまでの音声AIの多くは、「音声認識(聞く)→ 推論モデル(考える)→ 音声合成(話す)」という3つの別々の仕組みを継ぎ足して動かしていました。この構成では、それぞれの受け渡しのたびに遅延が生じます。相手の発言をいったん文字に起こし、それを推論モデルに渡して考えさせ、出てきた答えをまた音声に変換する、という順番の作業になるためです。
さらに、相手が話している途中で割り込んできたときの対応や、相槌のタイミング、雑音や沈黙をどう扱うかといった細かい調整は、開発者が個別に作り込む必要がありました。人間同士の会話であれば当たり前にできる「相手の話を聞きながら、相槌を打ちながら考える」という動きを、継ぎ足し構成で再現するのは簡単ではなかったということです。
GPT-Live-1は、この「聞く」と「話す」を1つのモデルで同時に扱う設計になっています。公式発表では、この構成によって音声まわりの処理がシンプルになるとしたうえで、次の6つの強みを挙げています。
- 割り込み処理: 入力と出力の音声を1つのモデルでまとめて推論するため、相手が話し始めたときの反応が自然になる
- 推論・ツール呼び出しの委譲: 込み入った判断や外部システムの呼び出しは、GPT-6 Astraなど別の推論モデル(自社製・他社製を問わず組み合わせ可能)に任せる設計
- 口調・話速・会話スタイルの指定: システムプロンプトで、話す速さや丁寧さといった雰囲気を指定できる
- 雑音・沈黙の扱い: 会話を止めたり、雑音や沈黙のたびに逐一反応したりせずに処理する
- 長い会話での安定性: 長時間のやり取りでも文脈を保持し続ける
- 電話対応への対応: 電話回線を使った全二重の音声エージェントを、レストランの予約からカスタマーサポートまで想定して設計している
ここで注目したいのは2番目の「推論の委譲」という設計です。GPT-Live-1自体は音声のやり取りに専念し、複雑な判断が必要な場面では別の推論モデルに考えさせる、という役割分担になっています。公式発表では、高頻度で発生する定型的なやり取り(予約の確認や注文内容の更新など)には軽量なモデルを、複雑な問い合わせには高度な推論モデルを、というように使い分ける例も紹介されています。つまり「音声の窓口」と「頭脳」を別々に選べる構成だということです。
なお、GPT-Live-1はターン制(発言の順番を区切って処理する方式)のモデルではありませんが、誰がいつ話し終えたかを検知する「ターン検出」の仕組みはネイティブに備えているとされています。また、話した内容の文字起こしと、AIの応答テキストの両方をあわせて出力できる点も特徴で、英数字の聞き取りやキーワードを優先的に聞き取らせる調整にも対応しているとのことです。
3. 実際に使っている企業の声
公式発表では、すでにGPT-Live-1を導入している企業の声がいくつか紹介されています。技術的な性能ではなく、業務がどう変わったかという観点で見てみます。
Yelp(Yelp Host / Hatch)は、電話での予約受付や料理の注文対応にGPT-Live-1を使っています。同社のCTOであるAlex Levy氏によると、会話のテンポと聞き取りの精度が改善したことで、電話対応率が有意に改善したとされています。また、電話をかけてきた相手側が、より完結した自然な文章で話すようになったという変化も挙げられています。これは、AIが自然に相槌を打ちながら聞く姿勢を見せることで、相手も話しやすくなった、という捉え方ができそうです。
語学学習サービスのSpeakでは、学習者が話す内容を考える時間を十分に確保できるようになり、従来のターン制の音声AIと比べて、学習者への割り込みが約80%減少したとされています。語学学習という、相手の発話の途中で機械的に遮ってしまうと体験を大きく損なう用途で、この改善は大きな意味を持ちます。
ある医療系スタートアップのCTOであるTony Stoyanov氏は、従来の「継ぎ足し構成」からGPT-Live-1に切り替えたことで、コードベースを80%削減でき、2万3千行のコードを削除できたと述べています。予約の受付から受診案内まで、患者との自然な会話が可能になったとのことです。開発・保守の負担が大きく下がった、という声として読み取れます。
このほか、カスタマーサポート向けサービスのFin(Intercom社)や、コーディングエージェントのCognition(Devin)でも活用されているとされ、デモ動画にはYelp、Cognition、Picsart、HeyGen、OpenAI Presenceなどの利用例が紹介されています。
これらの事例に共通しているのは、「AIの受け答えが賢くなった」という話よりも、「会話のテンポが自然になり、相手が話しやすくなった」「開発・保守の手間が減った」という、運用面での変化が語られている点です。中小企業が電話対応にAIを導入する際にも、同じような効果が期待できるかどうかは、実際に試してみないと分からない部分ではありますが、判断材料としては参考になります。
4. 料金の読み方 ― 1分5セントは「音声の入口」だけ
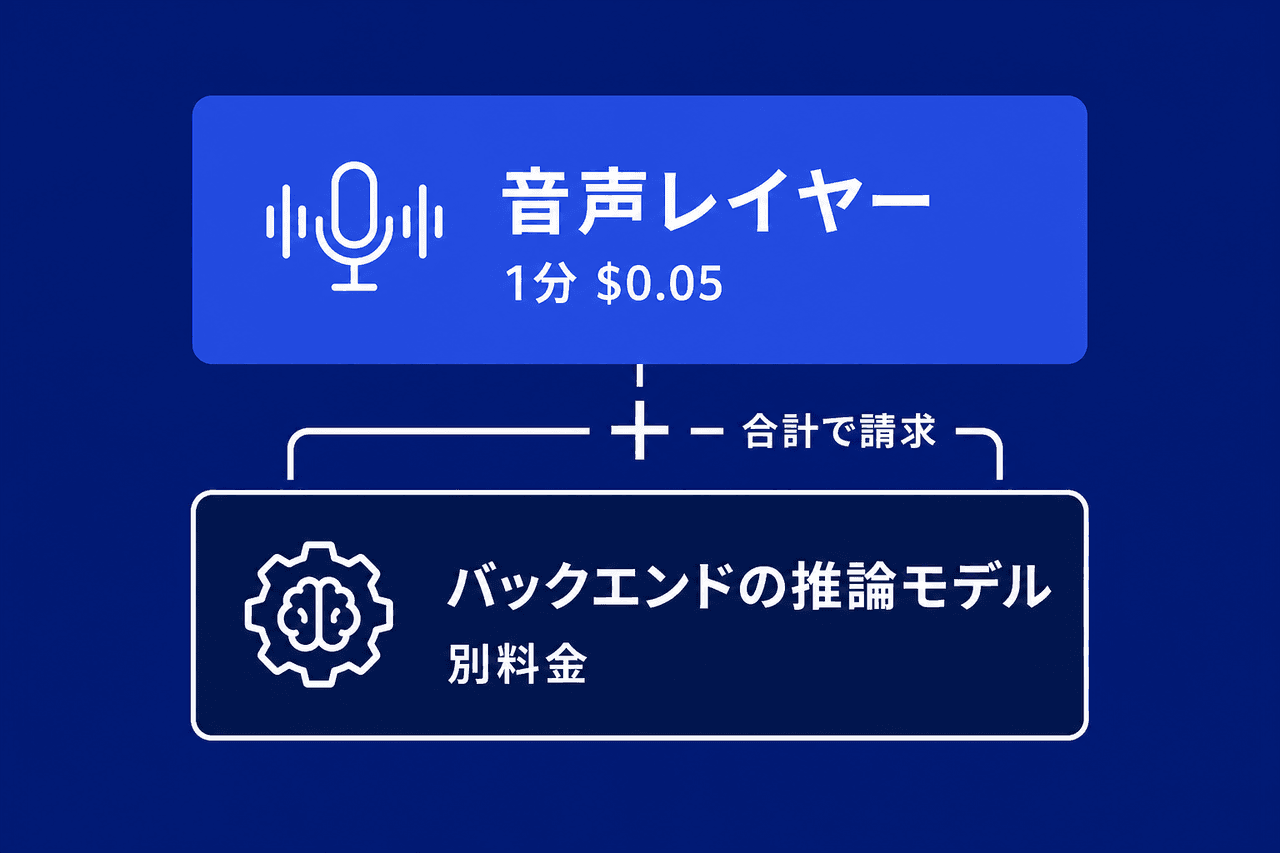
ここが最も誤解されやすいポイントです。公式発表で示された「1分あたり0.05ドル」という料金は、GPT-Live-1という音声のやり取りを担う部分(音声レイヤー)だけの価格です。公式APIドキュメントによると、この料金は秒単位で課金される仕組みになっています。
一方で、会話の中身を考える推論モデル(GPT-6 Astraなど)や、外部システムを呼び出すエージェントの基盤は別料金です。つまり、電話対応AIを組む場合の実際のコストは「音声レイヤーの料金」+「バックエンドの推論モデルの料金」の合計になります。GPT-Live-1単体の料金だけを見て、電話対応AI全体のコストと考えてしまうと、実際の請求額とズレが生じる可能性があります。
試算してみる(前提を明示した概算)
あくまで一例として、次の前提で音声レイヤー部分だけの費用を試算してみます。
- 1日あたりの着信件数: 100件
- 1件あたりの平均通話時間: 3分
この場合、音声レイヤーの費用は次のようになります。
100件 × 3分 × 0.05ドル = 1日あたり15ドル
1か月(30日)に換算すると、音声レイヤーだけで概算450ドルです。ここに、バックエンドの推論モデルの利用料金が別途上乗せされる、という点を必ず踏まえておく必要があります。推論モデルの料金は、どのモデルをどの程度の頻度・複雑さで呼び出すかによって変わるため、一律の金額を示すことはできません。実際に導入を検討する場合は、想定する会話の複雑さに応じて、開発を依頼する会社やベンダーに見積もりを取ることをおすすめします。
既存のRealtime APIとの単純比較はできない
OpenAIにはこれまでも、音声を扱う「Realtime API」という仕組みがありました。こちらはトークン単位の課金体系で、第三者による試算では音声入力が100万トークンあたり32ドル、出力が64ドル程度とされ、これを1分あたりに概算すると0.10ドル前後になるという情報もあります(この数字は公式発表ではなく第三者の試算です)。
GPT-Live-1は分単位・全二重という異なる課金体系の新しいエンドポイントであり、OpenAIが既存のRealtime APIを廃止するとした記述は、本記事の作成時点で確認できていません。両者は並存する選択肢と捉えるのが妥当で、課金の仕組みも前提も異なるため、単純に金額だけを比較することはできない点に注意してください。
5. 使い始める前に知っておくこと
導入を検討する前に、公式情報から確認できる範囲で、押さえておくべき点を整理します。
電話(SIP)への対応: 公式発表では、電話回線を使った全二重の音声エージェントに対応するとされています。公式APIドキュメントによれば、接続方式としてWebRTC(ブラウザ向け)、WebSocket(サーバー向け)に加えて、電話向けのTelephony/SIP接続にも対応しています。ただし、これらを組み合わせて実際に自社の電話窓口として動かすには、開発者による実装が必要です。既製のSaaSのように、契約してすぐ使えるものではありません。
同時に受けられる通話数には上限がある: 公式APIドキュメントによると、同時に開けるセッション数の上限は契約している利用ティアによって異なり、目安として低いティアで25セッション、高いティアで500セッションとされています。着信が集中する時間帯がある業種では、この上限を事前に確認しておく必要があります。
日本語対応の状況は明確でない: 新しい音声として12種類(Quartz、Ripple、Vesper、Willow、Stone、Gleam、Meridian、Bossa、Tempo、Beacon、Delta、Cinderという名称)が用意され、アクセントや方言、言語をまたいで拡充されたとされていますが、日本語での対応品質や、どの言語にどこまで対応しているかの詳しいリストは、本記事の作成時点で公式に明示されていません。公式は「今後数か月で音声の選択肢と対応言語を拡大していく」としており、現時点では確認できていない、というのが正確なところです。
企業向けにはOpenAI Presenceという基盤もある: GPT-Live-1を土台にした、企業向けの音声エージェント基盤「OpenAI Presence」も用意されています。質問対応や問題解決、社内システムの操作、承認済みのアクションの実行、対応しきれない場合の人間へのエスカレーションといった機能が想定されており、アカウント担当者経由での提供とされています。自社で一から開発する体力がない場合は、こうした基盤やベンダー経由での導入を検討する選択肢もあります。
音声には電子透かしが入る: 報道によれば、2026年7月31日以降、GPT-Live経由の音声(ChatGPT Voice・API双方)には、SynthIDという電子透かしとC2PAマニフェストが付与されており、検証用のツールやAPIも用意されているとのことです。ただし、透かしが検出されないからといって、それが人間による発話である証明にはならない、とOpenAI自身が注記しているとも報じられています。あわせて、生成コンテンツへの表示義務を定めたEU AI Act第50条が2026年8月2日に施行されており、時期が重なっている点も報道で指摘されています。声のクローンを作る際の同意確認プロセスなど、詳細な運用ルールについては、本記事の作成時点で確認できていません。
カスタム音声は審査制: 自社独自の音声を作りたい場合は、営業への問い合わせと適格性審査が必要とされています。誰でもすぐに独自の声を作れるわけではない、という点は覚えておいてください。
6. 中小企業はいま何をすべきか
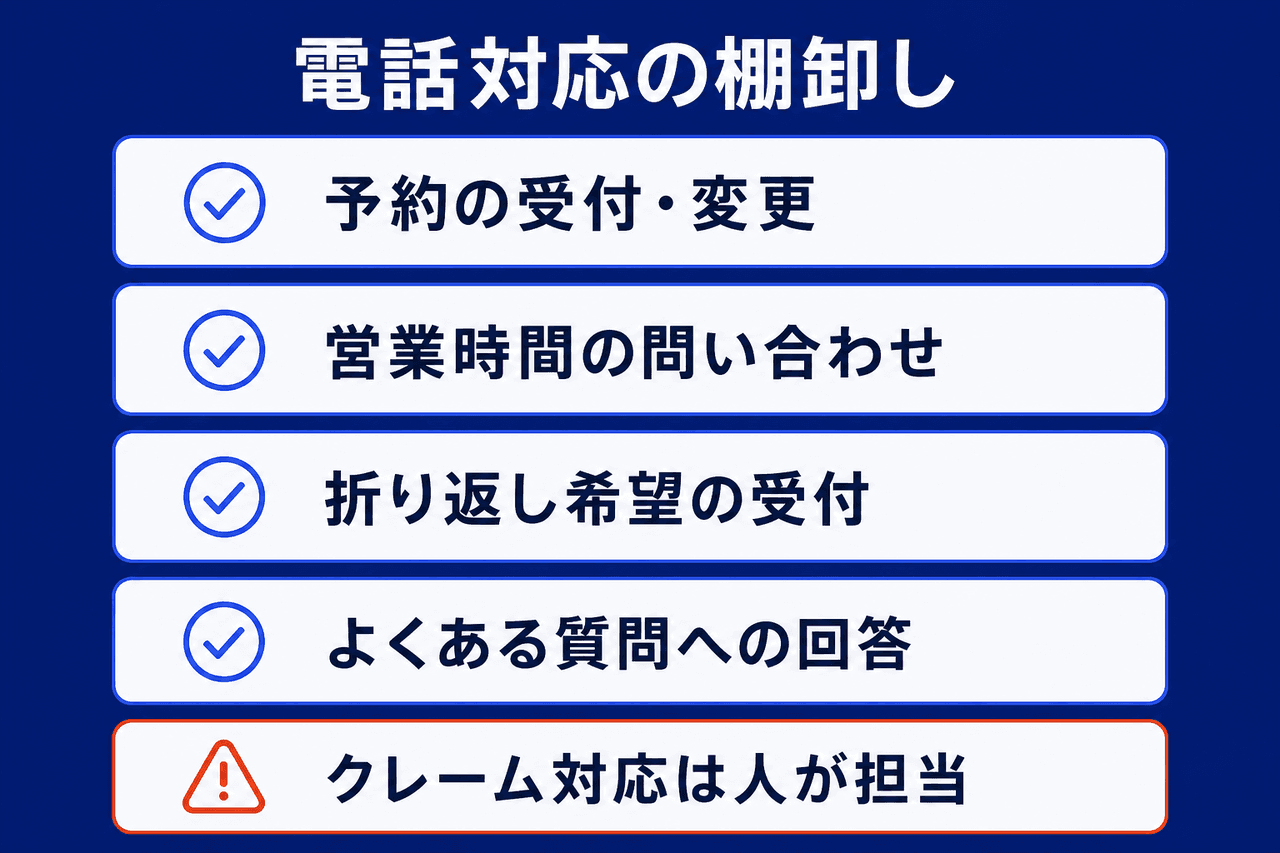
こうした状況を踏まえると、電話対応や予約受付をAIに任せることを検討している中小企業が、まず取り組むべきことは次の3つに整理できます。
(1) 電話対応のどこを任せるか、棚卸しする
すべての電話対応をいきなりAIに任せる必要はありません。まずは、次のような定型的なやり取りから検討するのが現実的です。
- 予約の受付・変更・キャンセルの一次対応
- 営業時間や所在地など、決まった内容への問い合わせ対応
- 担当者が不在の際の、折り返し希望の受付
- よくある質問への一次回答
一方で、料金交渉やクレーム対応、契約内容に関わる込み入ったやり取りなど、判断の余地が大きい業務は、当面は人が対応する範囲として残しておく方が安全です。定型業務から始めて、AIの応答の精度や顧客の反応を見ながら、任せる範囲を少しずつ広げていくという進め方が現実的です。
(2) 同意・録音・なりすまし対策の社内ルールを決めておく
電話の相手に対して、AIが対応していることをどう伝えるか、通話内容を録音・記録する場合の同意をどう取るか、といった社内ルールをあらかじめ決めておく必要があります。あわせて、AIの音声を使ったなりすましのリスクにどう備えるか(例えば、重要な意思決定を電話の音声だけで完結させない、といった運用上の工夫)についても、社内で認識をそろえておくことをおすすめします。前述の通り、電子透かしなどの技術的な対策は進んでいますが、それだけに頼り切らず、業務プロセス側でも備えておく方が現実的です。
(3) 自社開発ではなく、開発会社やSaaS経由で試す
GPT-Live-1は開発者向けのAPIであり、自社の電話窓口として動かすには、SIP接続や推論モデルとの組み合わせなど、相応の開発が必要です。社内にエンジニアリソースがない場合は、まず開発会社に依頼するか、GPT-Live-1やOpenAI Presenceのような基盤を活用したSaaS型のサービスを探すところから始めるのが現実的な進め方です。小さく試して効果を確かめてから、投資を広げるかどうかを判断する流れをおすすめします。
7. まとめ
- OpenAIは2026年9月10日、聞きながら話す全二重の音声AI「GPT-Live-1」のAPI提供を開始しました。同じ仕組みは2026年7月にChatGPTの音声機能として先に導入されています
- 従来の「聞く→考える→話す」を継ぎ足す構成と異なり、1つのモデルで音声のやり取りを扱う設計で、複雑な判断は別の推論モデルに委ねる構成になっています
- Yelp、Speak、医療系スタートアップなどの導入企業からは、会話のテンポの改善や開発・保守負担の軽減が報告されています
- 料金は音声レイヤーが1分あたり0.05ドルですが、これは音声の入口部分だけの価格で、バックエンドの推論モデルの料金は別途かかります。既存のRealtime APIとの単純比較もできません
- 日本語対応の詳細やSIP実装には開発者の関与が必要です。まずは定型的な電話対応から棚卸しし、開発会社やSaaS経由で小さく試すのが現実的です
料金体系や対応言語、提供条件は今後変わる可能性があります。導入を検討する際は、必ず公式サイトと公式APIドキュメントで最新情報を確認してください。
出典・参考
本記事は、2026年9月10日のGPT-Live-1 API提供開始発表をもとに、公式発表・公式APIドキュメントの内容を中心にまとめたものです。制度・価格・提供条件は変更される場合があるため、最新情報は公式サイトでご確認ください。
- Build more natural voice experiences with GPT‑Live‑1 in the API|OpenAI公式(2026年9月10日) https://openai.com/index/introducing-gpt-live-1-in-the-api/
- Introducing GPT-Live|OpenAI公式(2026年7月8日、ChatGPTでの先行導入) https://openai.com/index/introducing-gpt-live/
- GPT-Live-1 モデル情報(API仕様・接続方式)|OpenAI Developer Platform https://developers.openai.com/api/docs/models/gpt-live-1
※ 本記事中「公式発表」「公式APIドキュメント」と明記した内容は、いずれもOpenAIが自ら発表・公開した一次情報です。評価指標(Full Duplex Bench・Tau3など)の個別の数値については、公式発表本文には具体的な数値の記載がなく、報道記事が引用したグラフの読み取り値であるため、本記事では確度を明示できない数値として本文には掲載していません。
※ 日本語対応の品質・対応言語のリスト、コンテキスト長、正式提供(GA)かプレビュー版かの区別、Azure OpenAIでの提供有無、日本企業による導入事例、声のクローンにおける同意確認プロセスの詳細については、本記事の作成時点で確認できる公式情報がなく、記載していません。